Konvolyutsion neyron tarmoqlar (Convolutional Neural Networks)
1. Umumiy Ko'rinish
Konvolyutsion Neyron Tarmoqlar (CNN yoki ConvNet) og'irliklar va biaslardan iborat neyronlardan tashkil topgan. Har bir neyron ma'lumot qabul qiladi, nuqtaviy ko'paytma (dot product) bajaradi va ixtiyoriy ravishda chiziqli bo'lmagan funksiya orqali o'tkaziladi. Butun tarmoq hali ham yagona differentsiallashuvchi skor funksiyasini ifodalaydi: bir tomonda xom piksel qiymatlaridan, ikkinchi tomonda sinf skorlarigacha. Ular hali ham oxirgi (to'liq ulangan) qatlamda yo'qotish funksiyasiga (masalan, SVM/Softmax) ega va oddiy Neyron Tarmoqlarni o'rgatish uchun ishlab chiqqan barcha maslahat va usullar hali ham amal qiladi.
Nima o'zgaradi? ConvNet arxitekturalari kiruvchi ma'lumotlar rasmlar ekanligini aniq taxmin qiladi, bu esa bizga arxitekturaga ma'lum xususiyatlarni kodlash imkonini beradi. Ular forward funksiyani amalga oshirishni samarali qiladi va tarmoqdagi parametrlar sonini keskin kamaytiradi.
1.1 Arxitekturaga umumiy nazar
Oddiy neyron tarmoqlar
Neyron Tarmoqlar kirish (bitta vektor) qabul qiladi va uni bir qator yashirin qatlamlar orqali o'zgartiradi. Har bir yashirin qatlam bir to'plam neyronlardan iborat bo'lib, har bir neyron oldingi qatlamdagi barcha neyronlarga to'liq ulangan. Bir qatlamdagi neyronlar butunlay mustaqil ishlaydi va hech qanday ulanishlarni ulashmaydi. Oxirgi to'liq ulangan qatlam "chiqish qatlami" deb ataladi va klassifikatsiya sharoitida sinf skorlarini ifodalaydi.
Oddiy neyron tarmoqlar to'liq rasmlarga yaxshi miqyoslanmaydi
CIFAR-10 da rasmlar faqat 32x32x3 o'lchamida (32 kenglik, 32 balandlik, 3 rang kanali), shuning uchun oddiy Neyron Tarmoqning birinchi yashirin qatlamidagi bitta to'liq ulangan neyron 32×32×3 = 3072 og'irlikka ega bo'ladi. Bu miqdor hali boshqarish mumkin bo'lib ko'rinadi, ammo bu to'liq ulanish tuzilmasi kattaroq rasmlarga miqyoslanmaydi. Masalan, 200×200×3 o'lchamli rasm 200×200×3 = 120,000 og'irlikka ega neyronlarga olib keladi. Bundan tashqari, bir nechta shunday neyronlarga ega bo'lishimiz kerak bo'ladi, shuning uchun parametrlar tez to'planadi. Bu to'liq ulanish isrofgarchilik qiladi va parametrlarning katta soni tezda ortiqcha o'rganishga (overfitting) olib keladi.
3D neyron hajmlari
Konvolyutsion Neyron Tarmoqlar kirish rasmlari ekanligidan foydalanadi va arxitekturani yanada mantiqiy tarzda cheklaydi. Xususan, oddiy Neyron Tarmoqdan farqli o'laroq, ConvNet qatlamlarining neyronlari 3 o'lchamda joylashtirilgan: kenglik, balandlik, chuqurlik (bu yerda chuqurlik so'zi aktivatsiya hajmining uchinchi o'lchamini anglatadi, tarmoqdagi qatlamlar sonini emas). Masalan, CIFAR-10 dagi kirish rasmlari 32×32×3 o'lchamli kirish aktivatsiyalari hajmi bo'lib, hajm o'lchamlari mos ravishda 32×32×3 (kenglik, balandlik, chuqurlik). Bir qatlamdagi neyronlar to'liq ulangan tarzda emas, balki oldingi qatlamning faqat kichik mintaqasiga ulanadi. Bundan tashqari, CIFAR-10 uchun yakuniy chiqish qatlami 1×1×10 o'lchamlariga ega bo'ladi, chunki ConvNet arxitekturasi oxiriga kelib butun rasmni chuqurlik o'lchami bo'yicha joylashtirilgan sinf skorlari vektoriga siqib qo'yamiz.
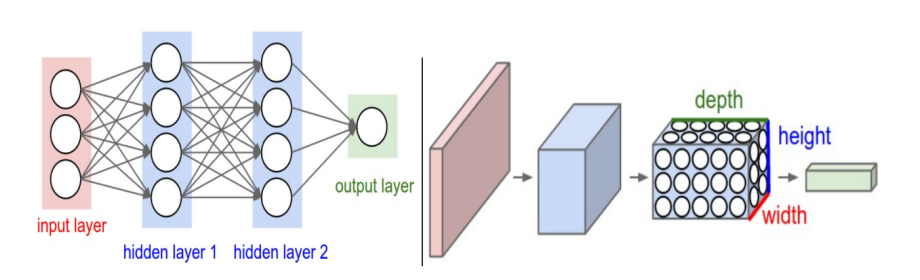
ConvNet neyronlarini 3 o'lchamda (kenglik, balandlik, chuqurlik) joylashtirilishi — qatlamlardan birida tasvirlangan
ConvNet qatlamlardan iborat. Har bir qatlam oddiy APIga ega: u kirish 3D hajmini ba'zi differentsiallanadigan funksiya orqali chiqish 3D hajmiga o'zgartiradi va bu funksiyaning parametrlari bo'lishi yoki bo'lmasligi mumkin.
1.2 Namunaviy arxitektura: umumiy ko'rinish
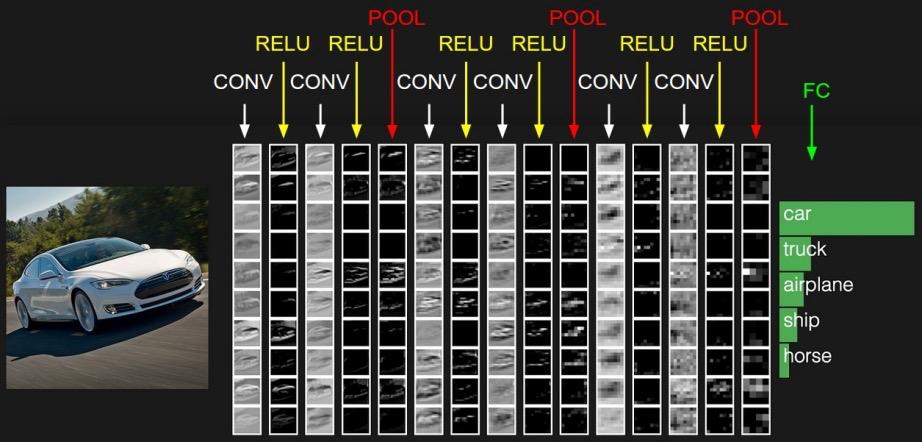
CIFAR-10 klassifikatsiyasi uchun oddiy ConvNet arxitekturasiga misol: . Batafsil:
- INPUT [32x32x3] — rasmning xom piksel qiymatlarini saqlaydi, bu holda kenglik 32, balandlik 32 va R, G, B uchun uchta rang kanali.
- qatlami — kirish hajmidagi mahalliy mintaqalarga ulangan neyronlar chiqishini hisoblaydi, ularning har biri o'zlari ulangan kichik mintaqa bilan og'irliklari o'rtasida nuqtaviy ko'paytma hisoblaydi. Masalan, 12 ta filtr ishlatsak [32x32x12] hajm hosil bo'lishi mumkin.
- qatlami — max(0,x) kabi element bo'yicha aktivatsiya funksiyasini qo'llaydi. Hajm o'lchami o'zgarishsiz qoladi ([32x32x12]).
- qatlami — fazoviy o'lchamlar (kenglik, balandlik) bo'yicha pastga namuna olish operatsiyasini bajaradi, masalan [16x16x12] hajm hosil bo'ladi.
- (to'liq ulangan) qatlam — sinf skorlarini hisoblaydi, [1x1x10] o'lchamli hajm hosil qiladi, bu yerda 10 ta raqamlarning har biri CIFAR-10 ning 10 ta kategoriyasidan biriga mos sinf skorini bildiradi.
Shunday qilib, ConvNetlar original piksel qiymatlaridan yakuniy sinf skorlarigacha rasmni qatlam-qatlam o'zgartiradi. Ba'zi qatlamlar parametrlarga ega, boshqalari esa emas. Xususan, CONV/FC qatlamlari faqat kirish hajmidagi aktivatsiyalargina emas, balki parametrlar (neyronlarning og'irliklari va biasi) funksiyasi bo'lgan transformatsiyalarni bajaradi. RELU/POOL qatlamlari esa qat'iy funksiyani amalga oshiradi. CONV/FC qatlamlaridagi parametrlar gradient descent yordamida o'qitiladi.
Xulosa qilib aytganda:
- ConvNet arxitekturasi eng oddiy holatda rasm hajmini chiqish hajmiga (masalan, sinf skorlarini saqlovchi) o'zgartiradigan Qatlamlar ro'yxatidir
- Bir nechta alohida Qatlam turlari mavjud (CONV/FC/RELU/POOL eng mashhuri)
- Har bir Qatlam kirish 3D hajmini qabul qiladi va differentsiallanadigan funksiya orqali chiqish 3D hajmiga o'zgartiradi
- Har bir Qatlamning parametrlari bo'lishi yoki bo'lmasligi mumkin (masalan, CONV/FC da bor, RELU/POOL da yo'q)
- Har bir Qatlamning qo'shimcha giperparametrlari bo'lishi yoki bo'lmasligi mumkin (masalan, CONV/FC/POOL da bor, RELU da yo'q)
2. ConvNet qatlamlarining tafsiloti
2.1 Konvolyutsion qatlam (Convolutional Layer)
Konvolyutsion qatlam hisoblash yukining asosiy qismini bajaradigan Konvolyutsion Tarmoqning asosiy qurilish blokidir.
Umumiy ko'rinish va intuitiv tushuncha
CONV qatlamining parametrlari o'rganiluvchi filtrlar to'plamidan iborat. Har bir filtr fazoviy jihatdan kichik (kenglik va balandlik bo'yicha), lekin kirish hajmining to'liq chuqurligini qamrab oladi. Masalan, ConvNet ning birinchi qatlamidagi odatiy filtr 5×5×3 o'lchamida bo'lishi mumkin (5 piksel kenglik va balandlik, va 3 — rang kanallari). Forward pass davomida har bir filterni kirish hajmining kengligi va balandligi bo'yicha surish (konvolyutsiya qilish) va filtr yozuvlari bilan ixtiyoriy pozitsiyadagi kirish o'rtasida nuqtaviy ko'paytma hisoblash amalga oshiriladi. Filterni kirish hajmining kengligi va balandligi bo'yicha surish jarayonida har bir fazoviy pozitsiyadagi filtr javoblarini beruvchi 2 o'lchovli aktivatsiya xaritasini hosil qilamiz. Intuitiv ravishda, tarmoq birinchi qatlamda qisman yo'naltirilgan qirra yoki ma'lum rangdagi dog' kabi ba'zi turdagi vizual xususiyatlarni ko'rganda faollashadigan filtrlarni o'rganadi, keyinchalik tarmoqning yuqori qatlamlarida butun asal quvurlari yoki g'ildirak shaklidagi naqshlarni o'rganadi.
Miya nuqtai nazaridan (The Brain View)
Agar siz miya/neyron analogiyalarini yoqtirsangiz, 3D chiqish hajmidagi har bir yozuv ham kirishning faqat kichik mintaqasiga qaraydigan va barcha neyronlar bilan parametrlarni ulashadigan neyron chiqishi sifatida talqin qilinishi mumkin (chunki bu raqamlarning barchasi bir xil filtrani qo'llash natijasida hosil bo'ladi).
Mahalliy ulanish (Local Connectivity)
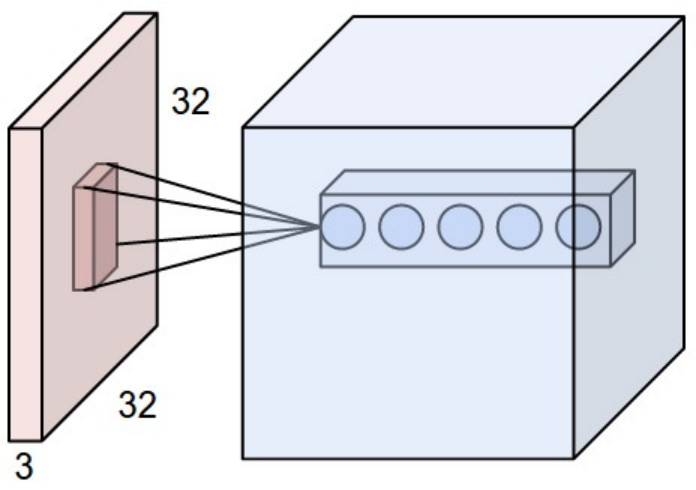
Rasmlar kabi yuqori o'lchovli kirishlar bilan ishlashda, yuqorida ko'rganimizdek, neyronlarni oldingi hajmdagi barcha neyronlarga ulash amaliy emas. Buning o'rniga, har bir neyronni kirish hajmining faqat mahalliy mintaqasiga ulaymiz. Bu ulanishning fazoviy ko'lami neyronning qabul qilish maydoni (receptive field) deb ataladigan giperparametr hisoblanadi (filtr o'lchami bilan tengdir). Chuqurlik o'qi bo'yicha ulanish ko'lami har doim kirish hajmining chuqurligiga teng.
Muhim asimmetriya: Fazoviy o'lchamlar (kenglik va balandlik) va chuqurlik o'lchamini qanday ko'rib chiqishimizda asimmetriya bor: Ulanishlar 2D fazoda (kenglik va balandlik bo'yicha) mahalliy, lekin kirish hajmining butun chuqurligi bo'yicha har doim to'liq.
1-misol: Kirish hajmi [32×32×3] bo'lsin (masalan, RGB CIFAR-10 rasmi). Agar qabul qilish maydoni (filtr o'lchami) 5×5 bo'lsa, Conv Qatlamdagi har bir neyron kirish hajmida [5×5×3] mintaqaga og'irliklarni ega bo'ladi — jami 5×5×3 = 75 og'irlik (+ 1 bias parametri). Chuqurlik bo'yicha ulanish 3 ga teng bo'lishi shart — chunki kirish hajmining chuqurligi 3.
2-misol: Kirish hajmi [16×16×20] bo'lsin. Qabul qilish maydoni o'lchami 3×3 deb faraz qilsak, Conv Qatlamdagi har bir neyron kirish hajmiga jami 3×3×20 = 180 ulanishga ega bo'ladi. Ulanish 2D fazoda mahalliy (3×3), lekin kirish chuqurligi bo'yicha to'liq (20).
Fazoviy Joylashuv (Spatial Arrangement)
Chiqish hajmining o'lchamini uchta giperparametr boshqaradi:
1. Chuqurlik (Depth)
Chiqish hajmining chuqurligi giperparametr hisoblanadi: u foydalanmoqchi bo'lgan filtrlar soniga mos keladi, ularning har biri kirishda turli narsalarni qidirishni o'rganadi. Masalan, birinchi Konvolyutsion Qatlam kirish sifatida xom rasmni qabul qilsa, chuqurlik o'lchami bo'yicha turli neyronlar turli yo'naltirilgan qirralar yoki rang dog'lari mavjudligida faollashishi mumkin. Barcha bir xil kirish mintaqasiga qaraydigan neyronlar to'plamini chuqurlik ustuni (depth column) deb ataymiz (ba'zilar ushbu atamani fibre deb ham afzal ko'radi).
2. Qadam (Stride)
Filterni qanday qadam bilan surishimizni belgilashimiz kerak. Qadam 1 bo'lganda filterni bir vaqtda bir piksel suramiz. Qadam 2 (yoki kamdan-kam hollarda 3 yoki undan ko'p) bo'lganda filtrlar surish paytida bir vaqtda 2 piksel sakraydi. Bu fazoviy jihatdan kichikroq chiqish hajmlarini hosil qiladi.
3. Nol to'ldirish (Zero-padding)
Ba'zida kirish hajmini chegara atrofida nollar bilan to'ldirish qulay bo'ladi. Nol to'ldirishning foydali xususiyati shundaki, u bizga chiqish hajmlarining fazoviy o'lchamini nazorat qilish imkonini beradi (ko'pincha kirish va chiqish kenglik va balandligi bir xil bo'lishi uchun ishlatiladi). P = (F-1)/2 formula bilan S = 1 bo'lganda kirish va chiqish hajmlari bir xil fazoviy o'lchamga ega bo'ladi.
Chiqish Hajmi Formulasi
Chiqish hajmining fazoviy o'lchamini quyidagi formula bilan hisoblash mumkin:
Chiqish o'lchami = (W - F + 2P) / S + 1
W — kirish o'lchami, F — filtr o'lchami, P — nol to'ldirish, S — qadam
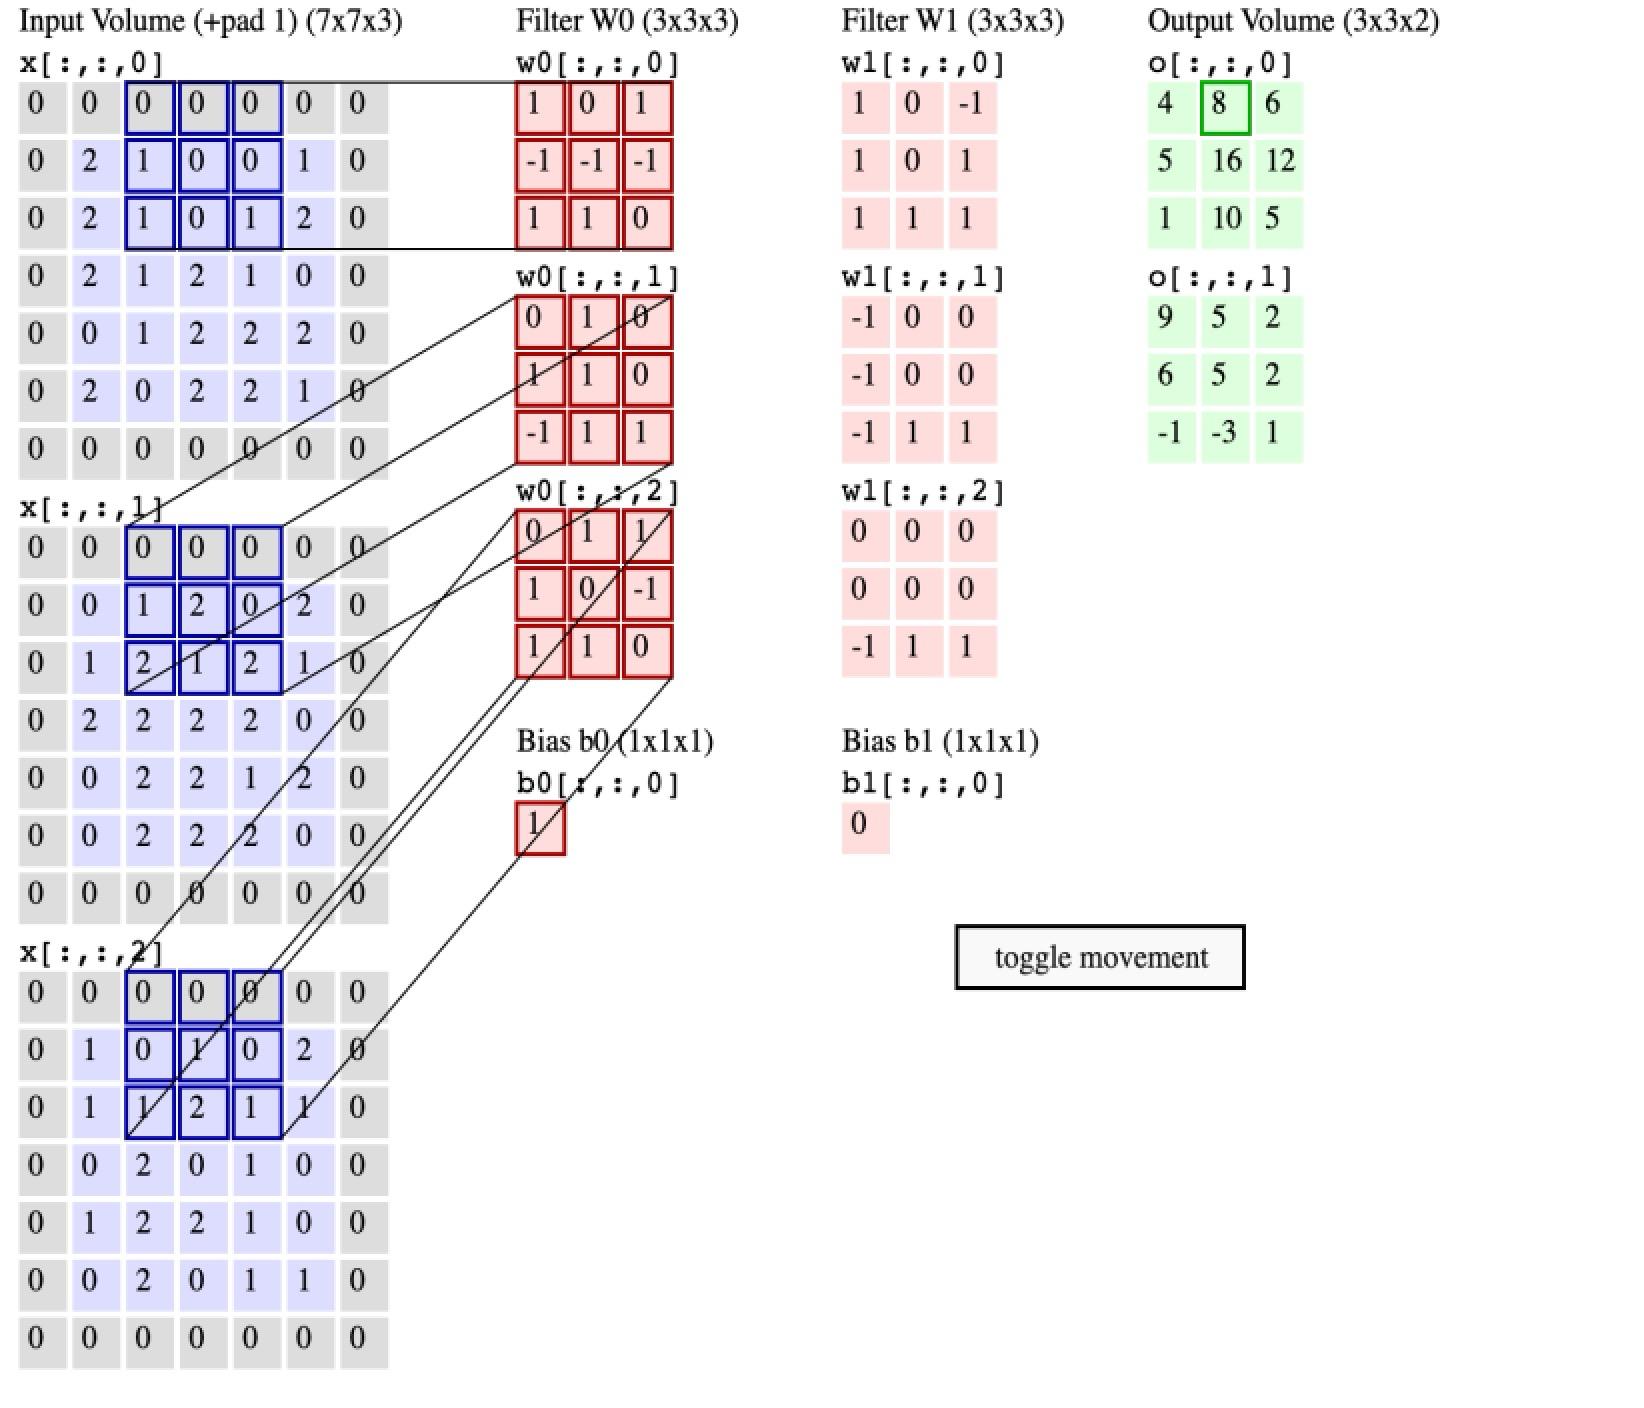
Misol: 7×7 kirish va 3×3 filtr uchun qadam S=1 va to'ldirish P=0 bilan: (7-3+0)/1+1 = 5 → 5×5 chiqish. Qadam S=2 bo'lsa: (7-3+0)/2+1 = 3 → 3×3 chiqish.
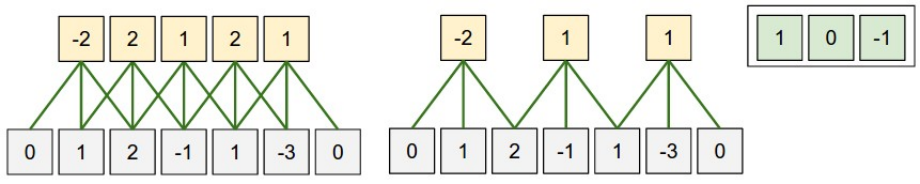
Parametrlarni Ulashish (Parameter Sharing)
Parametrlarni ulashish sxemasi Konvolyutsion Qatlamlarda parametrlar sonini nazorat qilish uchun ishlatiladi. Yuqoridagi haqiqiy dunyo misoli asosida: birinchi Conv qatlamda 55×55×96 = 290,400 neyron mavjud, ularning har biri 11×11×3 = 363 og'irlik va 1 biasga ega. Birga, bu birinchi qatlamda 290,400 × 364 = 105,705,600 ta parametrga teng keladi. Bu son juda ko'p.
Bir oqilona taxmin bilan parametrlar sonini keskin kamaytirishimiz mumkin: agar biror xususiyat (x,y) fazoviy pozitsiyasida hisoblash uchun foydali bo'lsa, u boshqa (x2,y2) pozitsiyasida ham foydali bo'lishi kerak. Har bir chuqurlik qismidagi neyronlarni bir xil og'irliklar va biaslardan foydalanishga majburlaymiz. Chuqurlik qismini chuqurlik dilimi (depth slice) deb ataymiz (masalan, [55×55×96] hajm 96 ta chuqurlik dilimiga ega, ularning har biri [55×55] o'lchamda).
Bu parametrlarni ulashish sxemasi bilan birinchi Conv qatramida endi faqat 96 ta noyob og'irlik to'plami (har bir chuqurlik dilimi uchun bittadan) mavjud bo'ladi — jami 96×11×11×3 = 34,848 ta noyob og'irlik, yoki 34,944 ta parametr (+96 bias). Amalda backpropagation davomida hajmdagi har bir neyron o'z og'irliklari uchun gradientni hisoblaydi, lekin bu gradientlar har bir chuqurlik dilimi bo'yicha jamlanadir va har bir dilim uchun faqat bitta og'irliklar to'plamini yangilaydi.
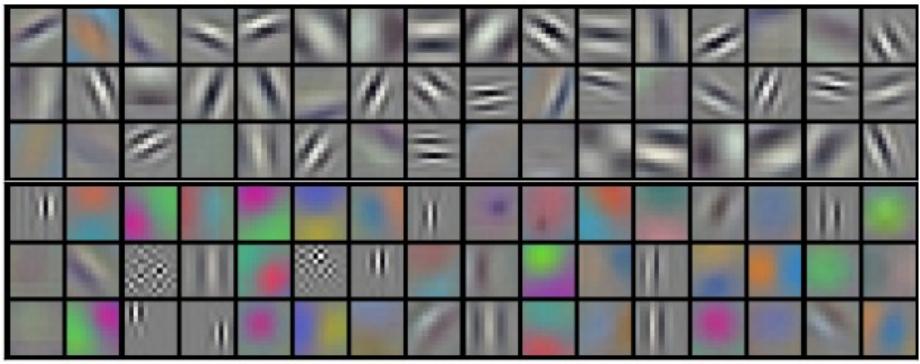
Ba'zan parametrlarni ulashish taxmini mantiqsiz bo'lishi mumkin. Bu, masalan, ConvNet ga kirish rasmlari rasmin markazlangan ma'lum bir tuzilishga ega bo'lganda sodir bo'ladi — masalan, markazlashtirilgan yuzlar. Bunday holda parametrlarni ulashish sxemasidan voz kechish va qatlamni oddiy Mahalliy Ulangan Qatlam (Locally-Connected Layer) deb atash odatiy hol.
Numpy misollari
Muhokamani aniqroq qilish uchun, xuddi shu g'oyalarni kod va aniq misol bilan ifodalaylik. Kirish hajmi numpy massivi deb faraz qilsak:
- (x,y) pozitsiyasidagi chuqurlik ustuni (depth column yoki fibre).
- d chuqurlikdagi chuqurlik dilimi yoki aktivatsiya xaritasi.
Conv Qatlam misoli: Kirish hajmi bo'lsin. Nol to'ldirish P=0, filtr o'lchami F=5, qadam S=2. Chiqish hajmining fazoviy o'lchami: (11-5)/2+1 = 4, ya'ni 4×4 o'lcham. chiqish hajmining aktivatsiya xaritasi (faqat ba'zi elementlar hisoblanadi):
Birinchi filtr W0 uchun (birinchi aktivatsiya xaritasi):
V[0,0,0] = np.sum(X[:5,:5,:] * W0) + b0V[1,0,0] = np.sum(X[2:7,:5,:] * W0) + b0V[2,0,0] = np.sum(X[4:9,:5,:] * W0) + b0V[3,0,0] = np.sum(X[6:11,:5,:]* W0) + b0
Bu yerda ning shakli (filtr o'lchami 5, kirish chuqurligi 4). Har bir nuqtada oddiy neyron tarmoqlarda ko'rganimizdek nuqtaviy ko'paytma hisoblanmoqda. Bir xil og'irlik va bias ishlatilmoqda (parametrlarni ulashish tufayli), kenglik bo'yicha o'lchamlar S=2 qadamda oshmoqda.
Ikkinchi filtr W1 uchun (ikkinchi aktivatsiya xaritasi, V ning 1-indeksi):
V[0,0,1] = np.sum(X[:5,:5,:] * W1) + b1V[1,0,1] = np.sum(X[2:7,:5,:] * W1) + b1V[2,0,1] = np.sum(X[4:9,:5,:] * W1) + b1V[3,0,1] = np.sum(X[6:11,:5,:] * W1) + b1V[0,1,1] = np.sum(X[:5,2:7,:] * W1) + b1V[2,3,1] = np.sum(X[4:9,6:11,:]* W1) + b1
Bu yerda ning ikkinchi chuqurlik o'lchamiga (1-indeks) indekslashni ko'rmoqdamiz, chunki ikkinchi aktivatsiya xaritasini hisoblamoqdamiz va boshqacha parametrlar to'plami () ishlatilmoqda. Bu aktivatsiya xaritalari ko'pincha ReLU kabi aktivatsiya funksiyasi orqali element bo'yicha o'tkaziladi, lekin bu yerda ko'rsatilmagan.
Conv Qatlamining To'liq Xulasasi
Conv Qatlami:
• W₁ × H₁ × D₁ o'lchamdagi hajmni qabul qiladi
• To'rtta giperparametr talab qiladi:
K — filtrlar soni
F — ularning fazoviy ko'lami (filtr o'lchami)
S — qadam (stride)
P — nol to'ldirish miqdori
• W₂ × H₂ × D₂ o'lchamdagi hajm chiqaradi, bu yerda:
W₂ = (W₁ − F + 2P) / S + 1
H₂ = (H₁ − F + 2P) / S + 1 (kenglik va balandlik simmetriya bo'yicha teng hisoblanadi)
D₂ = K
• Parametrlarni ulashish bilan har bir filtr uchun F⋅F⋅D₁ og'irlik kiritadi, jami (F⋅F⋅D₁)⋅K og'irlik va K ta bias.
• Chiqish hajmida d-chi chuqurlik dilimi (W₂×H₂ o'lchamida) d-chi filtrni S qadamli kirish hajmida to'g'ri konvolyutsiya qilish, so'ngra d-chi biasni qo'shish natijasida hosil bo'ladi.
Keng tarqalgan giperparametr sozlamalari: . Bundan tashqari ham ishlatiladi. Kattaroq filtrlar (masalan, 7×7) odatda faqat birinchi konvolyutsion qatlamda, kirish rasmiga to'g'ridan-to'g'ri qaraydigan qatlamda ishlatiladi.
Konvolyutsiya demosi (Animatsiya)
Matritsa Ko'paytmasi sifatida amalga oshirish
Konvolyutsiya operatsiyasi mohiyatan filtrlar va kirishning mahalliy mintaqalari o'rtasida nuqtaviy ko'paytmalarni bajaradi. CONV qatlamining keng tarqalgan amalga oshirish naqshi bu faktdan foydalanib, konvolyutsion qatlamning forward passini bitta katta matritsa ko'paytmasi sifatida ifodalaydi:
1. im2col operatsiyasi:
Kirish rasmdagi mahalliy mintaqalar deb ataladigan operatsiyada ustunlarga cho'ziladi. Masalan, kirish [227×227×3] va uni [11×11×3] filtrlar bilan S=4 qadamda konvolyutsiya qilish uchun, kirish hajmidagi [11×11×3] piksel bloklarini olib, har bir blokni 11×11×3 = 363 o'lchamli ustun vektoriga cho'zamiz. Bu jarayonni S=4 qadamda takrorlash har ikkala kenglik va balandlik bo'yicha (227-11)/4+1 = 55 ta joylashuvni beradi, natijada ning [363 × 3025] o'lchamli chiqish matritsasi hosil bo'ladi.
2. Og'irliklarni cho'zish:
CONV qatlamining og'irliklari ham qatorlarga cho'ziladi. Masalan, 96 ta [11×11×3] o'lchamli filtr bo'lsa, bu [96 × 363] o'lchamli matritsa hosil qiladi.
3. Matritsa ko'paytmasi:
Konvolyutsiya natijasi bitta katta matritsa ko'paytmasini bajarishga ekvivalent: , bu esa har bir filtr va har bir qabul qilish maydoni joylashuvining nuqtaviy ko'paytmasini hisoblaydi. Bizning misolimizda bu operatsiyaning chiqishi [96 × 3025] bo'ladi.
4.Qayta shakllantirish:
Natija nihoyat to'g'ri chiqish o'lchamiga [55×55×96] qayta shakllantirilishi kerak. Bu yondashuv ko'p xotira ishlatishi mumkin, chunki kirish hajmidagi ba'zi qiymatlar X_col da bir necha marta takrorlanadi. Biroq, afzallik shundaki, biz foydalanishimiz mumkin bo'lgan Matritsa Ko'paytmasining juda samarali implementatsiyalari mavjud (masalan, BLAS API).
1×1 Konvolyutsiya
Bir qancha maqolalar 1×1 konvolyutsiyalardan foydalanadi. Ba'zilar buni dastlab signal ishlov berish nuqtai nazaridan kulgili deb tushunadi (u shunchaki nuqtaviy masshtablash). Biroq, ConvNetlarda bu holat emas, chunki biz 3D hajmlar ustida ishlayotganimizni esga olish kerak va filtrlar har doim kirish hajmining to'liq chuqurligini qamrab oladi. Masalan, kirish [32×32×3] bo'lsa, 1×1 konvolyutsiya qilish aslida 3D nuqtaviy ko'paytmalarni bajaradi (kirish chuqurligi 3 kanal).
Kengaytirilgan Konvolyutsiyalar (Dilated Convolutions)
So'nggi ishlanma (masalan, Fisher Yu va Vladlen Koltunning maqolasiga qarang) — CONV qatlamiga deb ataladigan yana bir giperparametr kiritishdir. Hozirgacha biz faqat bir-biriga tutash CONV filtrlarni muhokama qildik. Biroq, har bir katakcha o'rtasida bo'shliqlar bo'lgan filtrlarga ega bo'lish mumkin — bu kengaytirilgan konvolyutsiya. Masalan, 1D da 3 o'lchamli filtr kirish ustida hisoblaydi:Dilation=0: w[0]*x[0] + w[1]*x[1] + w[2]*x[2]Dilation=1: w[0]*x[0] + w[1]*x[2] + w[2]*x[4]
Bu ba'zi hollarda juda foydali, chunki u kamroq qatlamlar bilan kirishlar bo'yicha fazoviy ma'lumotlarni yanada agressiv birlashtirish imkonini beradi. Masalan, ikki 3×3 CONV qatlamini stack qilsangiz, ikkinchi qatlamdagi neyronlar kirishning 5×5 patchining funksiyasi ekanligi isbotlanadi (samarali qabul qilish maydoni 5×5). Kengaytirilgan konvolyutsiyalar ishlatilganda bu samarali qabul qilish maydoni tezroq o'sadi.
2.2 Pooling qatlami
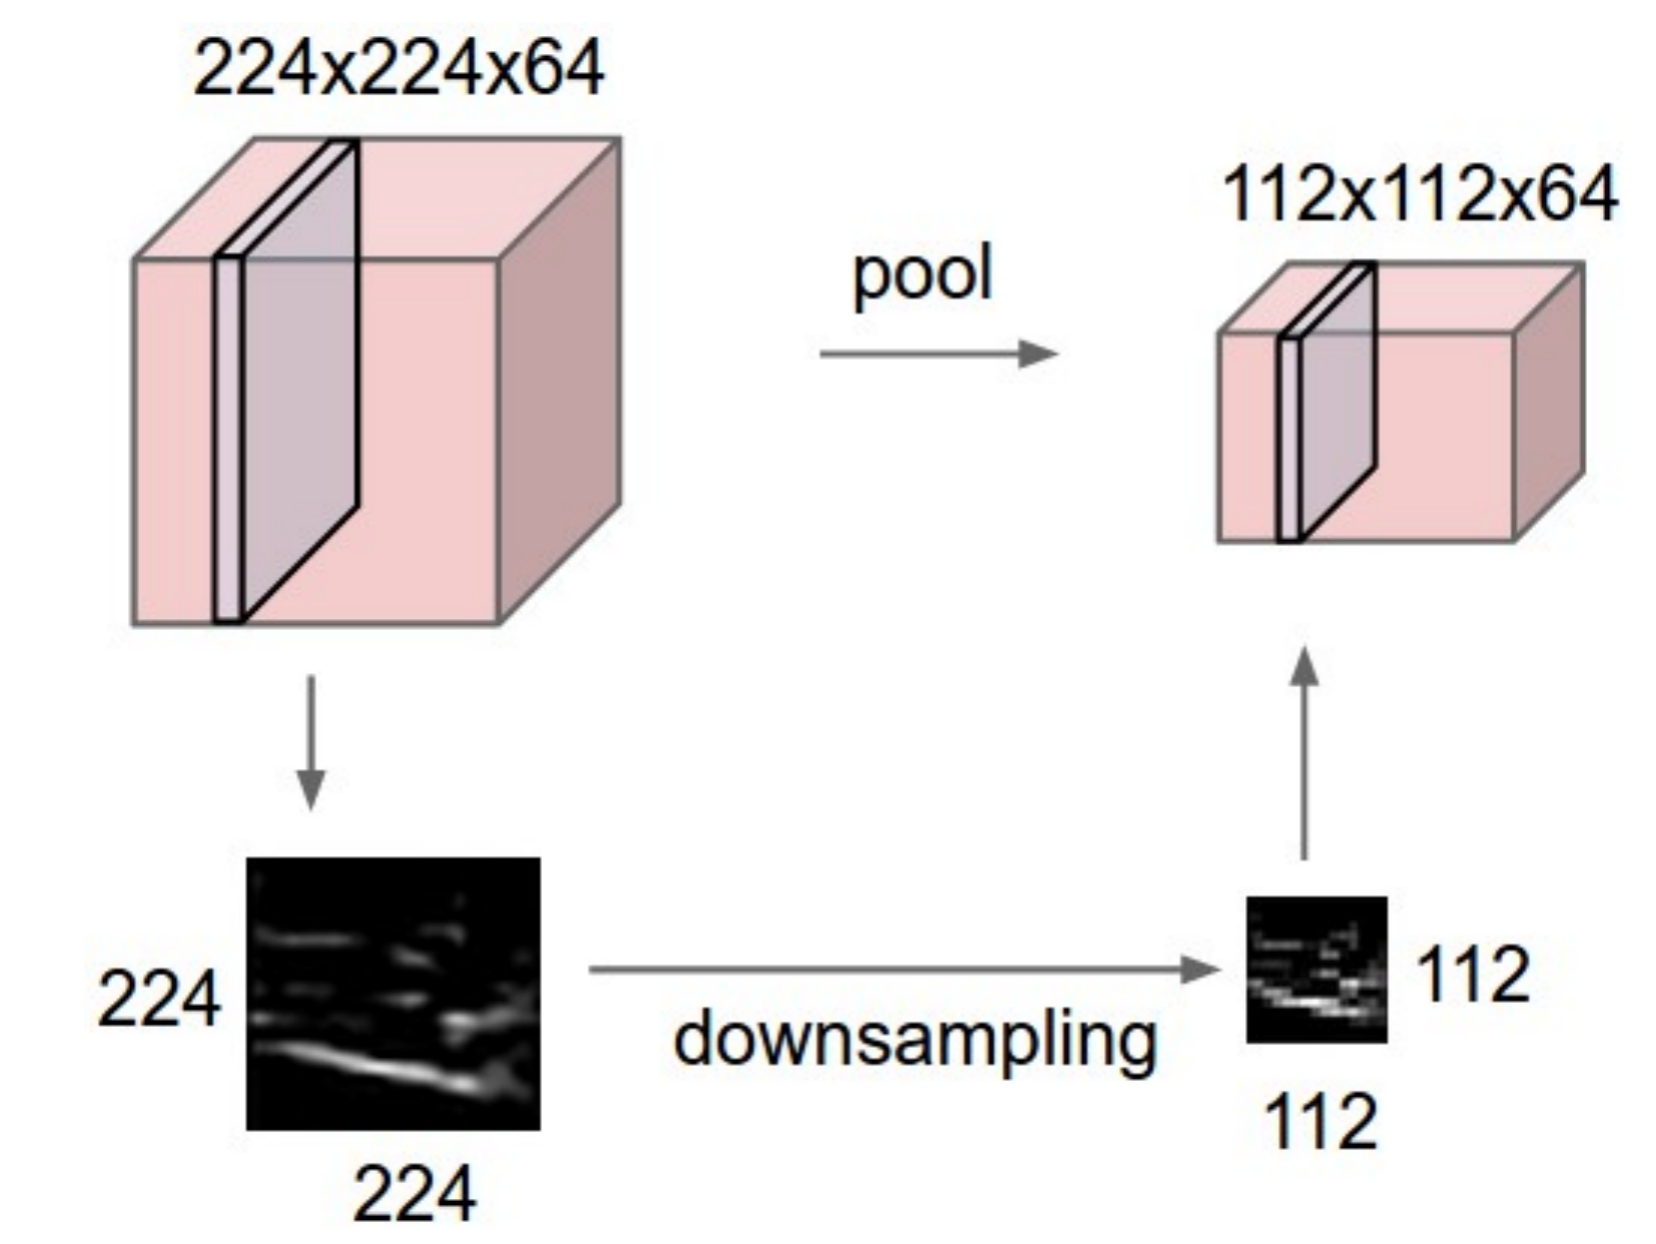
ConvNet arxitekturasida ketma-ket Conv qatlamlar orasiga davriy ravishda Pooling qatlami qo'shish odatiy hol. Uning vazifasi tarmoqdagi parametrlar va hisob-kitoblar hajmini kamaytirish uchun tasvirni progressiv ravishda kichraytirishdir — bu esa haddan tashqari o'rganishni (overfitting) nazorat qilishga yordam beradi.
Pooling qatlami kirishning har bir chuqurlik qismida mustaqil ishlaydi va uni MAX operatsiyasidan foydalanib fazoviy jihatdan o'lchamini o'zgartiradi. Eng keng tarqalgan shakl — har ikkala kenglik va balandlik bo'ylab 2 omil bilan har bir chuqurlik qismini kichraytiruvchi, aktivatsiyalarning 75% ini yo'qotuvchi 2×2 filtrlar bilan qadam 2 da qo'llaniladigan pooling qatlami. Har bir MAX operatsiyasi bu holda 4 ta raqam (kichik 2×2 mintaqa) ustida max hisoblaydi. Chuqurlik o'lchami o'zgarmaydi.
Pooling qatlamining xossalari:
• W₁ × H₁ × D₁ o'lchamdagi hajmni qabul qiladi
• Ikkita giperparametr talab qiladi: F (fazoviy ko'lam) va S (qadam)
• W₂×H₂×D₂ o'lchamdagi hajm chiqaradi:
W₂ = (W₁ − F) / S + 1
H₂ = (H₁ − F) / S + 1
D₂ = D₁ (chuqurlik o'zgarmaydi)
• Nolga teng parametrlarni kiritadi — kirishning qat'iy funksiyasini hisoblaydi
• Pooling qatlamlari uchun nol to'ldirish odatiy emas
Amalda faqat ikkita keng tarqalgan max pooling qatlam variatsiyasi uchraydi: F=3, S=2 (qoplanuvchi pooling deb ham ataladi) va odatiyroq F=2, S=2. Kattaroq qabul qilish maydonlari juda yo'qotuvchi.
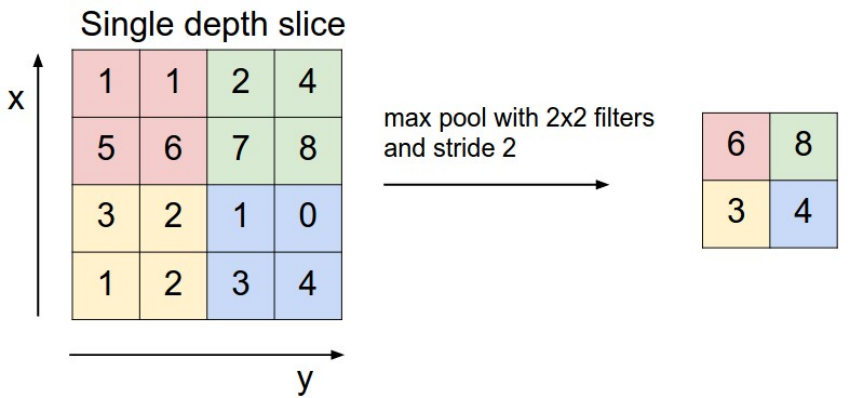
Umumiy Pooling
Max poolingdan tashqari, pooling birliklari boshqa funksiyalarni ham bajarishi mumkin, masalan, o'rtacha pooling (average pooling) yoki L2-norma pooling. O'rtacha pooling tarixan ko'p ishlatilgan, lekin hozirda amalda yaxshiroq ishlashi ko'rsatilgan max pooling operatsiyasiga nisbatan kam qo'llanilmoqda.
Backpropagation
Backpropagation bobidan eslatib o'tamiz: max(x,y) operatsiyasining orqaga o'tishi shunchaki gradientni forward passda eng yuqori qiymatga ega bo'lgan kirishga yo'naltirish sifatida talqin qilinadi. Shuning uchun pooling qatlamining forward passida max aktivatsiyaning indeksini kuzatib borish odatiy hol (ba'zan switches deb ham ataladi) — backpropagation paytida gradient yo'naltirish samarali bo'lishi uchun.
2.3 Normalizatsiya qatlami
ConvNet arxitekturalarida foydalanish uchun ko'plab normalizatsiya qatlam turlari taklif qilingan — ba'zan biologik miyoda kuzatilgan inhibition sxemalarini amalga oshirish maqsadida. Biroq bu qatlamlar amalda ularning hissasi minimal yoki umuman yo'q ekanligi ko'rsatilganligi sababli inobatga olinmay qolgan. Turli xil normalizatsiyalar haqida batafsil ma'lumot uchun Alex Krizhevskiyning cuda-convnet kutubxona API muhokamalariga qarang.
2.4 To'liq ulangan qatlam (Fully-Connected Layer)
To'liq ulangan qatlamdagi neyronlar oldingi qatlamdagi barcha aktivatsiyalarga to'liq ulanishga ega — oddiy Neyron Tarmoqlarda ko'rganimizdek. Ularning aktivatsiyalari shu tariqa matritsa ko'paytmasi va bias offset yordamida hisoblanishi mumkin. Batafsil ma'lumot uchun eslatmalarning Neyron Tarmoq bo'limiga qarang.
2.5 FC qatlamlarini CONV qatlamlariga konvertatsiya qilish
FC va CONV qatlamlar o'rtasidagi yagona farq shundaki, CONV qatlamidagi neyronlar kirishning faqat mahalliy mintaqasiga ulangan va CONV hajmidagi ko'plab neyronlar parametrlarni ulashadi. Biroq, ikkala qatlamdagi neyronlar hali ham nuqtaviy ko'paytma hisoblaydi, shuning uchun ularning funksional shakli bir xil. Shuning uchun FC va CONV qatlamlari o'rtasida konvertatsiya qilish mumkin:
- Istalgan CONV qatlam uchun bir xil forward funksiyani amalga oshiruvchi FC qatlam mavjud. Og'irlik matritsasi mahalliy ulanish tufayli aksariyat joylarda nolga teng va ko'p bloklarda og'irliklar teng bo'lgan katta matritsa bo'lardi.
- Aksincha, istalgan FC qatlamni CONV qatlamiga konvertatsiya qilish mumkin. Masalan, K=4096 bo'lgan va [7×7×512] kirish hajmiga qaraydigan FC qatlam parametrli CONV qatlam sifatida ekvivalent ifodalanishi mumkin. Filtr o'lchamini kirish hajmi o'lchamiga teng qilamiz va chiqish [1×1×4096] bo'ladi.
FC→CONV Konvertatsiyasi amaliy foydasi
224×224×3 rasmni qabul qiladigan va CONV va POOL qatlamlari seriyasidan foydalanib 7×7×512 o'lchamli aktivatsiya hajmiga kamaytiradigan AlexNet arxitekturasini ko'rib chiqamiz (5 ta pooling qatlami orqali, har safar 2 omil bilan, yakuniy fazoviy o'lcham 224/2/2/2/2/2 = 7). Undan so'ng AlexNet uchta FC qatlamdan foydalanadi. Bu uch FC qatlamning har birini CONV qatlamlariga quyidagicha konvertatsiya qilamiz:
- Birinchi FC qatlamni [7×7×512] hajmga qaraydigan F=7 filtr o'lchamli CONV qatlam bilan almashtirish → [1×1×4096] chiqish.
- Ikkinchi FC qatlamni F=1 filtr o'lchamli CONV qatlam bilan almashtirish → [1×1×4096] chiqish.
- Uchinchi FC qatlamni F=1 bilan almashtirish → [1×1×1000] yakuniy chiqish.
Bu konvertatsiya amalda original ConvNetni kattaroq rasm bo'yicha ko'plab fazoviy pozitsiyalarda yagona forward passda samarali surish imkonini beradi. Masalan, 224×224 rasm [7×7×512] hajm bersa (32 omil kichraytirish), 384×384 o'lchamli rasmni konvertatsiya qilingan arxitektura orqali o'tkazish [12×12×512] hajm beradi (384/32=12). Keyingi 3 ta CONV qatlam [6×6×1000] yakuniy hajmni beradi ((12-7)/1+1=6).
Original ConvNetni (FC qatlamlar bilan) 384×384 rasm bo'yicha 32 piksel qadamda mustaqil ravishda 224×224 croplar ustida baholash — konvertatsiya qilingan ConvNetni bir marta oldinga o'tkazish bilan bir xil natija beradi.
Tabiiyki, konvertatsiya qilingan ConvNetni yagona marta oldinga o'tkazish original ConvNetni barcha 36 ta joyda takrorlash bilan solishtirganda ancha samarali, chunki 36 ta baholash hisob-kitoblarni ulashadi. Bu usul amalda yaxshiroq ishlash uchun ko'pincha ishlatiladi — masalan, rasmni kattalashtirish, ko'plab fazoviy pozitsiyalarda sinf skorlarini baholash uchun konvertatsiya qilingan ConvNetdan foydalanish va keyin sinf skorlarini o'rtalashtirish odatiy hol.
3. ConvNet arxitekturalari
Biz Konvolyutsion Tarmoqlar odatda faqat uchta qatlam turidan iborat ekanligini ko'rdik: CONV, POOL va FC. Bundan tashqari, element bo'yicha chiziqli bo'lmaganlikni qo'llovchi RELU aktivatsiya funksiyasini ham alohida qatlam sifatida yozamiz. Ushbu bo'limda ularning to'liq ConvNetlarni tashkil etish uchun qanday stack qilinishini muhokama qilamiz.
3.1 Qatlam naqshlari
ConvNet arxitekturasining eng keng tarqalgan shakli bir nechta CONV-RELU qatlamlarni stack qiladi, ulardan so'ng POOL qatlamlarini qo'yadi va bu naqshni rasm fazoviy jihatdan kichik o'lchamga kelguncha takrorlaydi. Bir nuqtada to'liq ulangan qatlamlarga o'tish odatiy hol. Eng keng tarqalgan ConvNet arxitekturasi quyidagi naqshni kuzatadi:INPUT -> [[CONV -> RELU]*N -> POOL?]*M -> [FC -> RELU]*K -> FC
Bu yerda takrorlashni bildiradi, esa ixtiyoriy pooling qatlamini bildiradi. N≥0 (odatda N≤3), M≥0, K≥0 (odatda K<3). Masalan, ushbu naqshga amal qiladigan keng tarqalgan ConvNet arxitekturalari:
- chiziqli klassifikator. N=M=K=0.
- har bir POOL qatlam o'rtasida bitta CONV qatlam.
- har bir POOL qatlamdan oldin ikkita CONV qatlam. Chuqurroq va kattaroq tarmoqlar uchun yaxshi — bir nechta stack qilingan CONV qatlamlari halokatli pooling operatsiyasidan oldin kirishning yanada murakkab xususiyatlarini ishlab chiqishi mumkin.
Kichik filtrli CONV stack katta qabul qilish maydoni o'rniga afzalroq: Uchta 3×3 CONV qatlamini stack qilish va ular orasida chiziqli bo'lmagan funksiyalar bo'lishi bilan birinchi qatlamdagi neyron kirishning 3×3 ko'rinishiga ega, ikkinchi qatlamdagi neyron 5×5, uchinchi qatlamdagi neyron esa 7×7 ko'rinishga ega. Bitta 7×7 CONV qatlam ishlatish kamchiliklari: (1) neyronlar chiziqli funksiyani hisoblaydi, uchta stack qilingan CONV esa chiziqli bo'lmaganliklar tufayli ifodali; (2) 49C² parametrga nisbatan 27C² parametr kam. Amaliy kamchilik: backpropagation uchun barcha oraliq CONV qatlam natijalarini saqlash kerak bo'lganligi uchun ko'proq xotira.
3.2 Qatlam o'lchamlari naqshlari
Kirish qatlami: 2 ga ko'p marta bo'linadigan bo'lishi kerak. Odatiy raqamlar: 32 (CIFAR-10), 64, 96 (STL-10), 224 (keng tarqalgan ImageNet ConvNetlari), 384 va 512.
CONV qatlamlar: Kichik filtrlardan foydalanish kerak (3×3 yoki ko'pi bilan 5×5), S=1 qadam, va kirish hajmini o'zgarishsiz saqlaydigan nol to'ldirish — ya'ni F=3 uchun P=1, F=5 uchun P=2, umumiy holda P=(F-1)/2. Agar kattaroq filtr o'lchamlari ishlatilishi zarur bo'lsa (7×7 kabi), bu odatda faqat kirish rashmiga to'g'ridan-to'g'ri qaraydigan birinchi conv qatlamda kuzatiladi.
POOL qatlamlar: 2×2 qabul qilish maydoni (F=2) va S=2 qadam bilan max-pooling eng keng tarqalgan. Bu kirish hajmidagi aktivatsiyalarning aynan 75% ini yo'qotadi (kenglik va balandlik bo'ylab 2 omil bilan pastga namuna olish tufayli). F=3, S=2 biroz kamroq keng tarqalgan sozlama. Max pooling uchun 3 dan katta qabul qilish maydoni o'lchamlari juda yo'qotuvchi va agressiv bo'lgani uchun juda kam uchraydi — bu odatda yomonroq ishlashga olib keladi.
Xotira cheklovlari asosida murosaga kelish: Ba'zi hollarda (ayniqsa ConvNet arxitekturalarida dastlab), xotira miqdori yuqorida keltirilgan qoidalar bilan juda tez to'planishi mumkin. Masalan, 224×224×3 rasmni har birida 64 filtr va 1 to'ldirish bilan uchta 3×3 CONV qatlam orqali filtrlash [224×224×64] o'lchamli uchta aktivatsiya hajmini hosil qiladi. Bu jami taxminan 10 million aktivatsiya yoki har bir rasm uchun 72MB xotira (aktivatsiyalar va gradientlar uchun) tashkil etadi. GPU lar ko'pincha xotira bilan chegaralanganligi sababli, murosaga kelish kerak bo'lishi mumkin. Murosaga kelish odatda faqat tarmoqning birinchi CONV qatlamida amalga oshiriladi — masalan, ZF Net da filtr o'lchami 7×7 va qadam 2, AlexNet da esa 11×11 va qadam 4.
4. Hisoblash mulohazalari
ConvNet arxitekturalarini qurishda e'tiborga olinishi kerak bo'lgan eng katta to'siq xotira tiqilishidir. Ko'plab zamonaviy GPU larning 3/4/6GB xotira chegarasi mavjud, eng yaxshi GPU larda esa taxminan 12GB xotira bor. Kuzatib borish uchun uchta asosiy xotira manbai mavjud:
Oraliq hajm o'lchamlaridan: ConvNetning har bir qatlamidagi aktivatsiyalarning xom soni va ularning gradientlari (teng o'lchamda). Odatda aktivatsiyalarning ko'pchiligi ConvNet ning dastlabki qatlamlarida (ya'ni birinchi Conv Qatlamlarda) bo'ladi. Ular backpropagation uchun zarur bo'lganligi sababli atrofda saqlanadi, lekin ConvNetni faqat sinov vaqtida ishlaydigan aqlli implementatsiya printsipda buni katta miqdorda kamaytirishi mumkin — istalgan vaqtda faqat joriy qatlamdagi aktivatsiyalarni saqlab, quyi qatlamlardagi oldingi aktivatsiyalarni o'chirib.
Parametr o'lchamlaridan: tarmoq parametrlarini, backpropagation paytidagi ularning gradientlarini, va optimizatsiya momentum, Adagrad yoki RMSProp ishlatilayotgan bo'lsa, odatda qadam keshini saqlovchi raqamlar. Shuning uchun parametr vektorini saqlash uchun xotira odatda kamida 3 omilga ko'paytirilishi kerak.
Har bir ConvNet implementatsiyasi turli xotira saqlashi kerak: rasm ma'lumotlar to'plamlari, ehtimol ularning kuchaytirilgan versiyalari va hokazo.
Qiymatlarning umumiy sonini taxminiy baholashdan so'ng (aktivatsiyalar, gradientlar va turli xillar uchun), raqam GB dagi o'lchamga o'girilishi kerak. Qiymatlar sonini oling, xom baytlar sonini olish uchun 4 ga ko'paytiring (har bir suzuvchi nuqta 4 bayt, yoki ikki aniqlik uchun 8), keyin KB, MB va nihoyat GB olish uchun 1024 ga bir necha marta bo'ling. Agar tarmoqingiz sig'masa, odatiy evristika — partiya o'lchamini (batch size) kamaytirish, chunki xotiranin ko'pchiligi odatda aktivatsiyalar tomonidan sarflanadi.
Amaliy ish
https://github.com/ozodbek-bosimov/image-classification-using-cnn
1. Konvolyutsion neyron tarmoqlari (CNN)
1.1. Kirish
Konvolyutsion neyron tarmoqlari (Convolutional Neural Networks, CNN) — bu chuqur o'qitishning bir turi bo'lib, asosan tasvirlarni qayta ishlash uchun mo'ljallangan. An'anaviy neyron tarmoqlardan farqli ravishda, CNN tasvirning fazoviy (spatial) tuzilishini saqlab qoladi va konvolyutsiya operatsiyasi orqali muhim xususiyatlarni (features) avtomatik ravishda ajratib oladi.
CNN ning asosiy g'oyasi — filtrlar (kernellar) yordamida tasvirni skanerlash va turli xil xususiyatlarni (qirralar, burchaklar, teksturalar) bosqichma-bosqich aniqlash. Har bir keyingi qatlam oldingi qatlamdagi oddiy xususiyatlarni birlashtirib, murakkab xususiyatlarni hosil qiladi.
1.2. CNN qatlamlari
Convolutional Layer — filtrlar yordamida kirish tasviriga konvolyutsiya operatsiyasini qo'llaydi. Har bir filtr muayyan xususiyatni aniqlashga ixtisoslashadi.
MaxPooling Layer — xususiyat xaritalarining o'lchamlarini kamaytiradi. 2x2 oynada eng katta qiymatni tanlaydi. Hisoblash xarajatlarini kamaytiradi.
Batch Normalization — har bir mini-batch uchun kirish ma'lumotlarini normalizatsiya qiladi. O'qitish jarayonini barqarorlashtiradi va tezlashtiradi.
Dropout — o'qitish jarayonida tasodifiy neyronlarni o'chiradi. Overfitting (haddan tashqari moslanish) ning oldini oladi.
Dense Layer — barcha neyronlar oldingi qatlamdagi har bir neyron bilan bog'langan. Oxirgi qatlam tasniflash natijasini beradi.
1.3. Tasvirlarni tasniflash masalasi
Tasvirlarni tasniflash — bu berilgan tasvirni oldindan belgilangan kategoriyalardan biriga ajratish masalasidir. Bizning holatda ikkilik tasniflash (binary classification) amalga oshiriladi: har bir tasvir "mushuk" yoki "it" sinfiga ajratiladi. Model oxirida har bir sinf uchun ehtimollik qiymatini beradi va eng yuqori ehtimollikka ega sinf tanlanadi.
2. Loyiha tuzilishi va texnologiyalar
2.1. Texnologiyalar va kutubxonalar
| Texnologiya | Vazifasi |
| Python 3.10 | Asosiy dasturlash tili |
| TensorFlow / Keras | Chuqur o'qitish freymvorki |
| OpenCV | Tasvirlarni o'qish va qayta ishlash |
| NumPy | Raqamli hisoblashlar va massivlar |
| Matplotlib | Grafiklar va vizualizatsiya |
| Google Colab (T4 GPU) | Bulutli hisoblash muhiti |
2.2. Fayl tuzilmasi
image-classification-using-cnn/
+-- Code/
|   +-- constants.py        - Konfiguratsiya konstantalari
|   +-- data_prep.py        - Ma'lumotlarni yuklash va tayyorlash
|   +-- model.py            - CNN model arxitekturasi
|   +-- main.py             - Lokal o'qitish pipeline
+-- image_classification_cnn.ipynb  - Google Colab notebook
+-- output/                 - Natijalar va grafiklar
+-- requirements.txt        - Python kutubxonalari
+-- README.md               - Loyiha hujjati
3. Ma'lumotlar to'plami (DATASET)
3.1. Dataset tavsifi
Loyihada Kaggle platformasidagi "Dogs vs. Cats" musobaqasi uchun tayyorlangan ma'lumotlar to'plami ishlatildi.
| Parametr | Qiymat |
| Jami rasmlar soni | 25 000 ta |
| O'qitish uchun ishlatilgan | 18 000 ta |
| Sinflar | Mushuk (cat), It (dog) |
| O'rtacha o'lcham | 360x404 piksel |
| Format | JPEG |
| Manba | Google Drive orqali yuklandi |
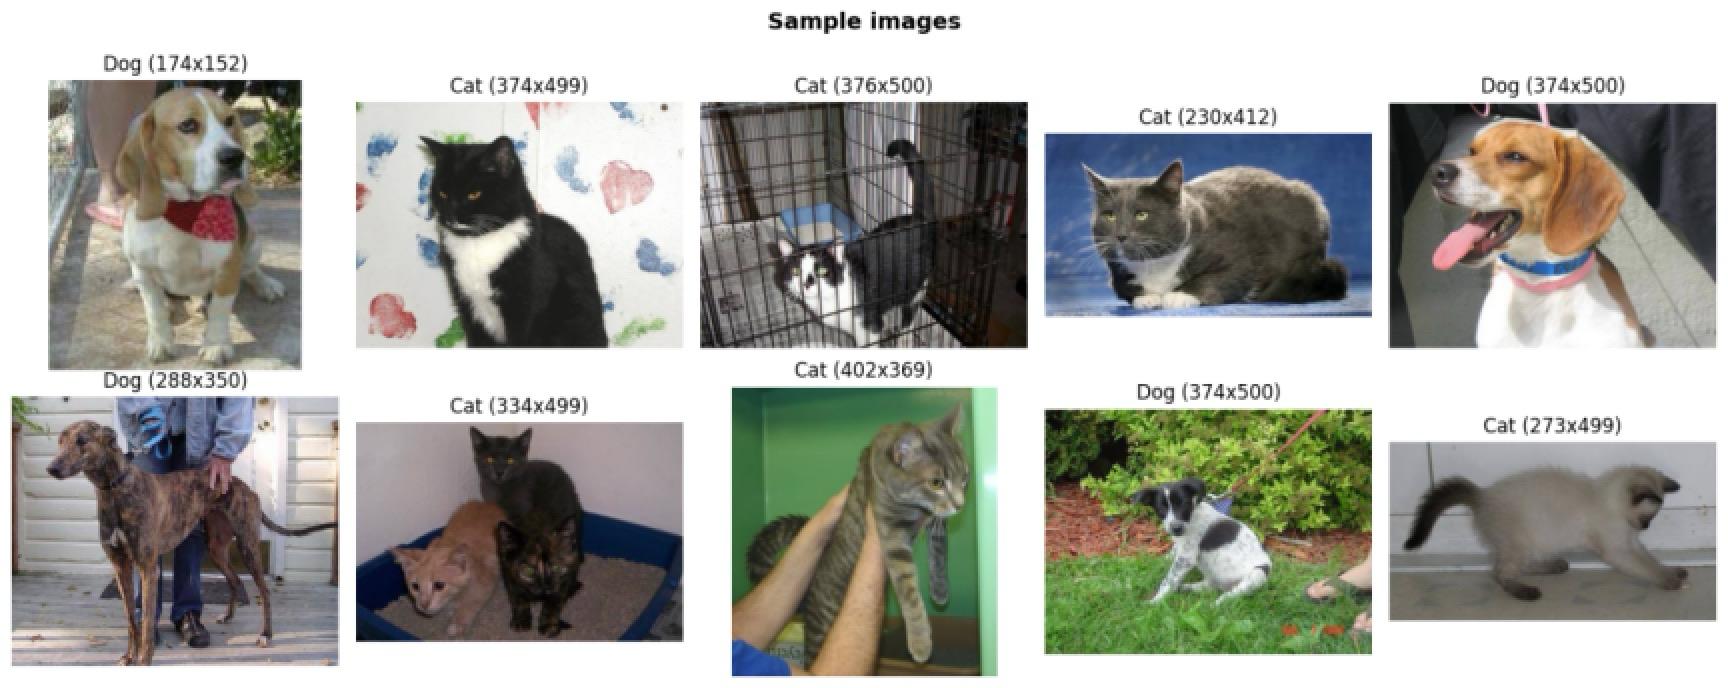
Rasm o'lchamlari statistikasi quyidagicha aniqlandi:
| Parametr | Balandlik | Kenglik |
| O'rtacha | 360.5 px | 404.1 px |
| Maksimal | 768 px | 1050 px |
| Minimal | 32 px | 42 px |
3.2. Namunaviy tasvirlar
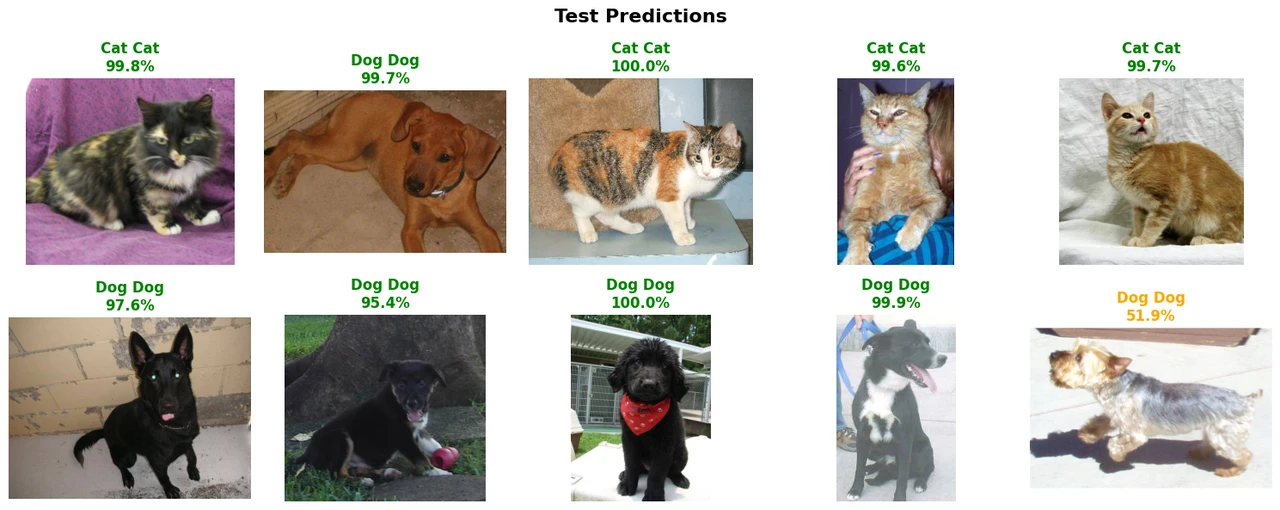
Quyida datasetdan tasodifiy tanlangan namunaviy rasmlar keltirilgan:
4. Dasturiy kod
Loyiha kodi modulli tuzilishga ega. Har bir fayl alohida vazifani bajaradi. Quyida har bir faylning kodi va tushuntirishi keltirilgan.
4.1. constants.py — Konfiguratsiya
Bu fayl loyihaning barcha asosiy sozlamalarini (yo'llar, giperparametrlar, yorliqlar) saqlaydi. Boshqa fayllar ushbu konstantalarni import qilib ishlatadi.
constants.py:
import os

ROOT_DIR = os.path.dirname(os.path.dirname(os.path.abspath(__file__)))

TRAIN_DIR = os.path.join(ROOT_DIR, 'train')
TEST_DIR = os.path.join(ROOT_DIR, 'test1')
OUTPUT_DIR = os.path.join(ROOT_DIR, 'output')
MODEL_DIR = os.path.join(ROOT_DIR, 'Code', 'models')

CAT_LBL = 0
DOG_LBL = 1
CAT = 'cat'
DOG = 'dog'
LABEL_MAP = {
    CAT: CAT_LBL,
    DOG: DOG_LBL
}
DATA_SIZE = 18_000
IMG_SIZE = 110
SPLIT_RATIO = 0.8
DATA_SIZE=18000 — datasetdan nechta rasm ishlatilishini belgilaydi. IMG_SIZE=110 — barcha rasmlar 110x110 pikselga o'zgartiriladi. SPLIT_RATIO=0.8 — ma'lumotlarning 80% o'qitish, 20% validatsiya uchun ishlatiladi.
4.2. data_prep.py — Ma'lumotlarni tayyorlash
Bu fayl rasmlarni diskdan o'qib, ularni neyron tarmoq uchun tayyorlaydi: o'lchamini o'zgartiradi, normalizatsiya qiladi va yorliq beradi.
data_prep.py:
import numpy as np
import os
from random import shuffle
import constants as CONST
import cv2

def label_img(name):
    """Fayl nomidan one-hot yorliq hosil qilish."""
    word_label = name.split('.')[0].lower()
    if word_label not in CONST.LABEL_MAP:
        return None
    label = CONST.LABEL_MAP[word_label]
    label_arr = np.zeros(2, dtype=np.float32)
    label_arr[label] = 1
    return label_arr

def prep_and_load_data():
    """Rasmlarni yuklash, o'lchamini o'zgartirish va normalizatsiya."""
    DIR = CONST.TRAIN_DIR
    data = []
    image_paths = os.listdir(DIR)
    shuffle(image_paths)
    count = 0
    for img_path in image_paths:
        label = label_img(img_path)
        if label is None:
            continue
        path = os.path.join(DIR, img_path)
        image = cv2.imread(path)
        if image is None:
            continue
        image = cv2.resize(image, (CONST.IMG_SIZE, CONST.IMG_SIZE))
        image = image.astype('float32') / 255.0
        data.append([image, label])
        count += 1
        if count % 1000 == 0:
            print(f"{count} images loaded...")
        if count >= CONST.DATA_SIZE:
            break
    shuffle(data)
    print(f"Total loaded: {len(data)} images")
    return data
Jarayon: 1) Fayl nomidan sinf aniqlanadi (cat.123.jpg -> Cat). 2) Rasm OpenCV bilan o'qiladi. 3) 110x110 ga o'zgartiriladi. 4) Piksel qiymatlari [0,1] ga normalizatsiya qilinadi. 5) Yorliqlar one-hot formatda: Cat=[1,0], Dog=[0,1].
4.3. model.py — CNN arxitekturasi
Bu fayl CNN modelini quradi. Model TensorFlow/Keras kutubxonasining Sequential API si yordamida yaratilgan.
model.py:
import tensorflow as tf
from tensorflow.keras.layers import (
    Dense, Dropout, Flatten, BatchNormalization,
    Conv2D, MaxPooling2D
)
import constants as CONST

def get_model():
    """CNN modelini qurish va kompilyatsiya qilish."""
    model = tf.keras.Sequential()

    model.add(Conv2D(32, kernel_size=(3, 3), activation='relu',
                     input_shape=(CONST.IMG_SIZE, CONST.IMG_SIZE, 3)))
    model.add(MaxPooling2D(pool_size=(2, 2)))
    model.add(BatchNormalization())

    model.add(Conv2D(64, kernel_size=(3, 3), activation='relu'))
    model.add(MaxPooling2D(pool_size=(2, 2)))
    model.add(BatchNormalization())

    model.add(Conv2D(96, kernel_size=(3, 3), activation='relu'))
    model.add(MaxPooling2D(pool_size=(2, 2)))
    model.add(BatchNormalization())

    model.add(Conv2D(96, kernel_size=(3, 3), activation='relu'))
    model.add(MaxPooling2D(pool_size=(2, 2)))
    model.add(BatchNormalization())
    model.add(Dropout(0.2))

    model.add(Conv2D(64, kernel_size=(3, 3), activation='relu'))
    model.add(MaxPooling2D(pool_size=(2, 2)))
    model.add(BatchNormalization())
    model.add(Dropout(0.2))

    model.add(Flatten())
    model.add(Dense(256, activation='relu'))
    model.add(Dropout(0.2))
    model.add(Dense(128, activation='relu'))
    model.add(Dropout(0.3))
    model.add(Dense(2, activation='softmax'))

    model.compile(
        loss='categorical_crossentropy',
        optimizer='adam',
        metrics=['accuracy']
    )
    return model
Model 5 ta konvolyutsion blok va 3 ta to'liq bog'langan qatlamdan iborat. Qatlamlar tuzilishi:
| Qatlam | Parametrlar | Chiqish |
| Conv2D | 32 filtr, 3x3, ReLU | 108x108x32 |
| MaxPooling2D | 2x2 | 54x54x32 |
| BatchNormalization | — | 54x54x32 |
| Conv2D | 64 filtr, 3x3, ReLU | 52x52x64 |
| MaxPooling2D | 2x2 | 26x26x64 |
| BatchNormalization | — | 26x26x64 |
| Conv2D | 96 filtr, 3x3, ReLU | 24x24x96 |
| MaxPooling2D | 2x2 | 12x12x96 |
| BatchNormalization | — | 12x12x96 |
| Conv2D | 96 filtr, 3x3, ReLU | 10x10x96 |
| MaxPool+BN+Dropout(0.2) | 2x2 | 5x5x96 |
| Conv2D | 64 filtr, 3x3, ReLU | 3x3x64 |
| MaxPool+BN+Dropout(0.2) | 2x2 | 1x1x64 |
| Flatten+Dense(256)+Dense(128) | ReLU, Dropout | 128 |
| Dense (chiqish) | 2 neyron, Softmax | 2 |
Kompilyatsiya: categorical_crossentropy yo'qotish funksiyasi (one-hot yorliqlar uchun), Adam optimallashtiruvchi va accuracy metrikasi bilan.
5. Natijalar va tahlil
5.1. Accuracy va Loss grafiklari
Quyidagi grafikda o'qitish jarayonidagi aniqlik va yo'qotish ko'rsatkichlarining o'zgarishi keltirilgan:
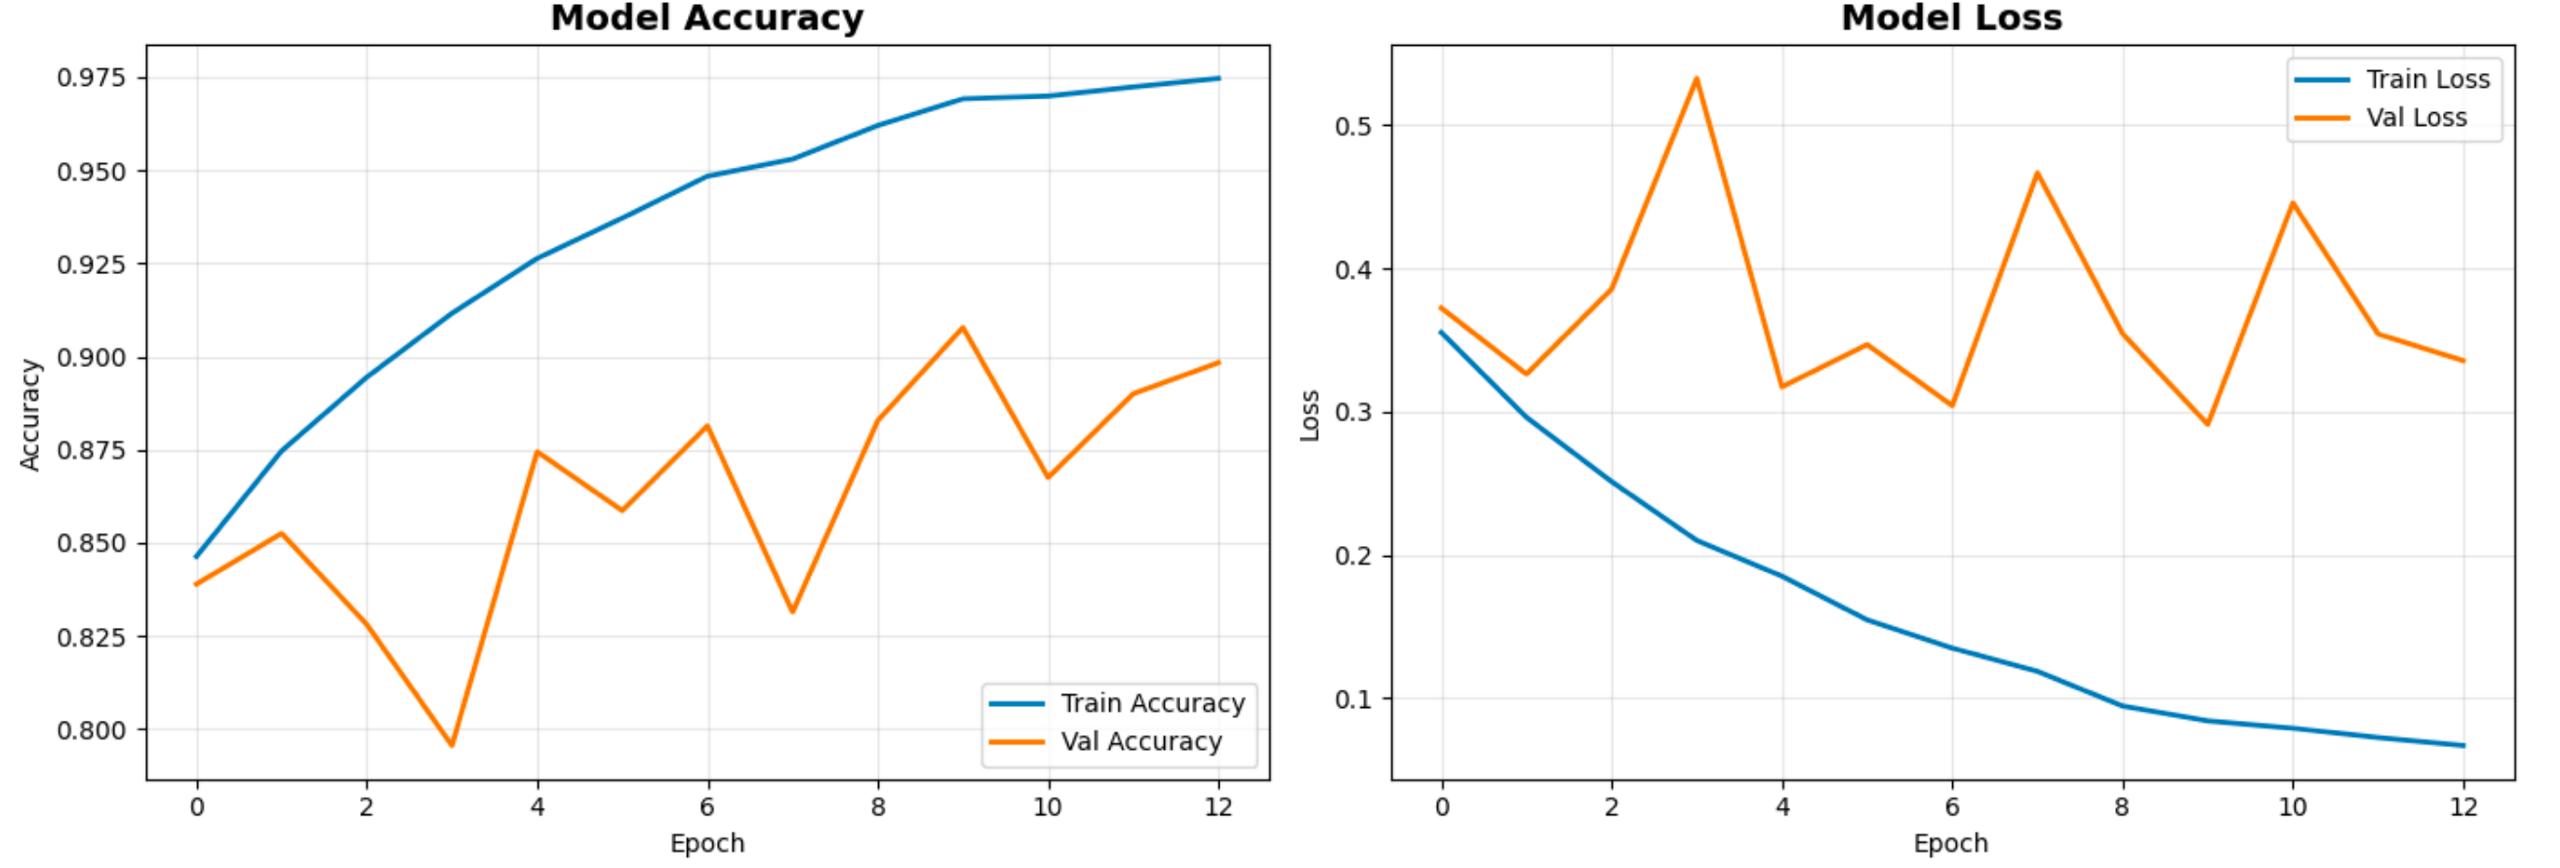
Grafiklardan ko'rinib turibdiki, Train Accuracy barqaror ravishda oshib borgan va 97.5% ga yetgan. Validation Accuracy esa 85-90% atrofida tebranib turdi. Bu orasidagi farq modelda ma'lum darajada overfitting mavjudligini ko'rsatadi.
Train Loss doimiy kamayib borgan bo'lsa-da, Validation Loss ba'zi davrlarda ortib ketgan. Buni Dropout va EarlyStopping bilan nazorat qilindi.
5.2 Xulosa
Ushbu amaliy ishda konvolyutsion neyron tarmoqlari yordamida mushuk va itlarni tasniflash masalasi muvaffaqiyatli hal qilindi. Asosiy natijalar:
- CNN modeli 18 000 ta rasm asosida 13 davr davomida o'qitildi va validatsiya to'plamida 89.83% aniqlikka erishdi.
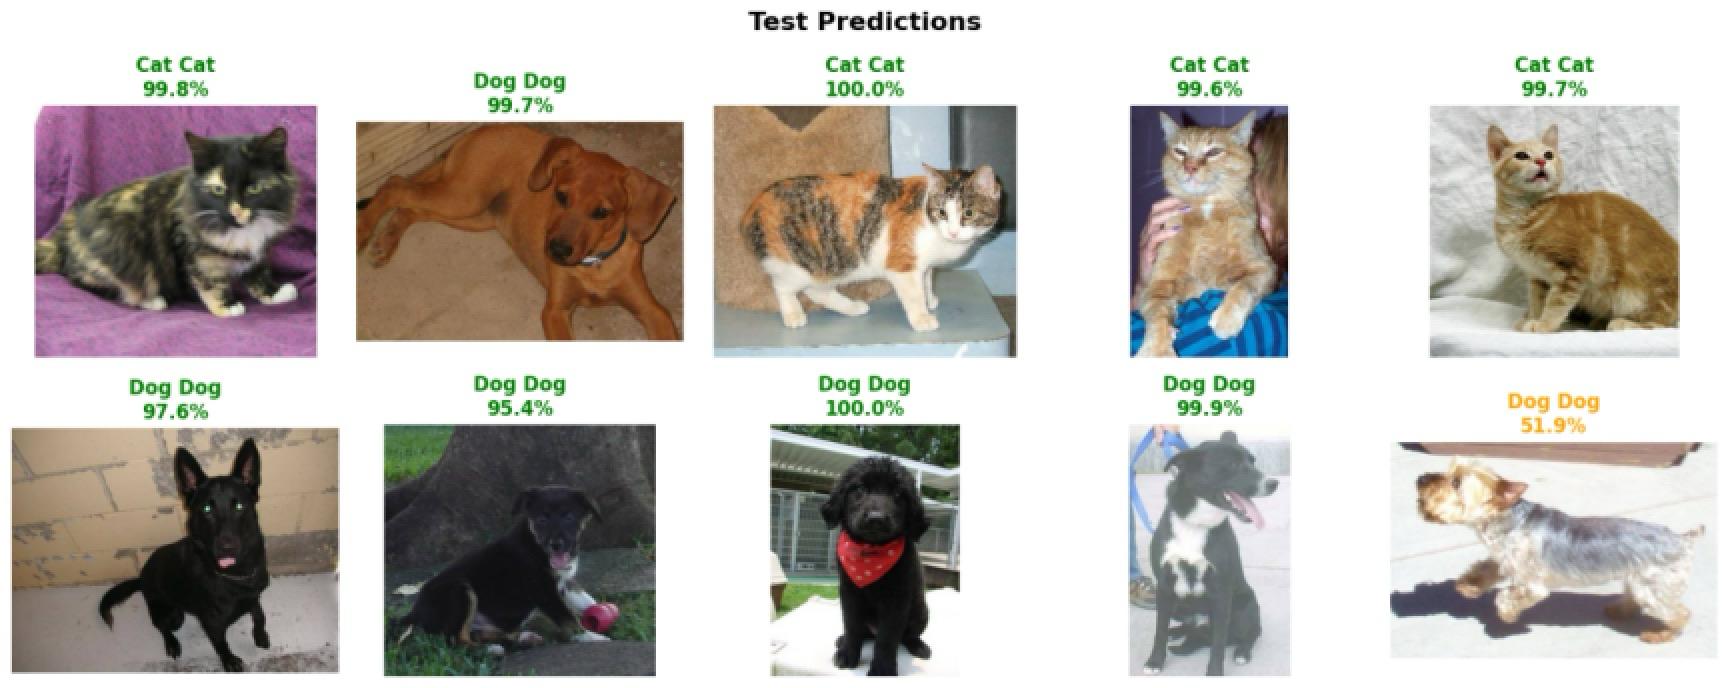
- Model test rasmlarida yuqori ishonchlilik bilan (ko'pchilik rasmlarda 95-100%) to'g'ri bashorat qildi.
- Foydalanuvchi tomonidan kiritilgan yangi rasmlarni ham 100% aniqlik bilan tasnifladi.
- Batch Normalization, Dropout va EarlyStopping texnikalari overfitting ni nazorat qilishda samarali bo'ldi.
- Loyiha Google Colab muhitida amalga oshirildi, bu GPU resurslariga qulay kirish imkonini berdi.